Repository navigation
【010-week4】算法训练营第四周学习总结 #197
Description

【010-week4】算法训练营第四周学习总结
第四周学习内容:
第四周习题训练以下内容:
- Trie树
- 分治算法
- 贪心算法
- 回溯算法
- 动态规划
Trie树
定义
Trie树,即字典树,又称单词查找树或键树,是一种树形结构,是⼀种哈希树的变种。典型应⽤是统计和排序大量的字符串(但不仅限于字符串),所以经常被搜索引擎系统用于文本词频统计。
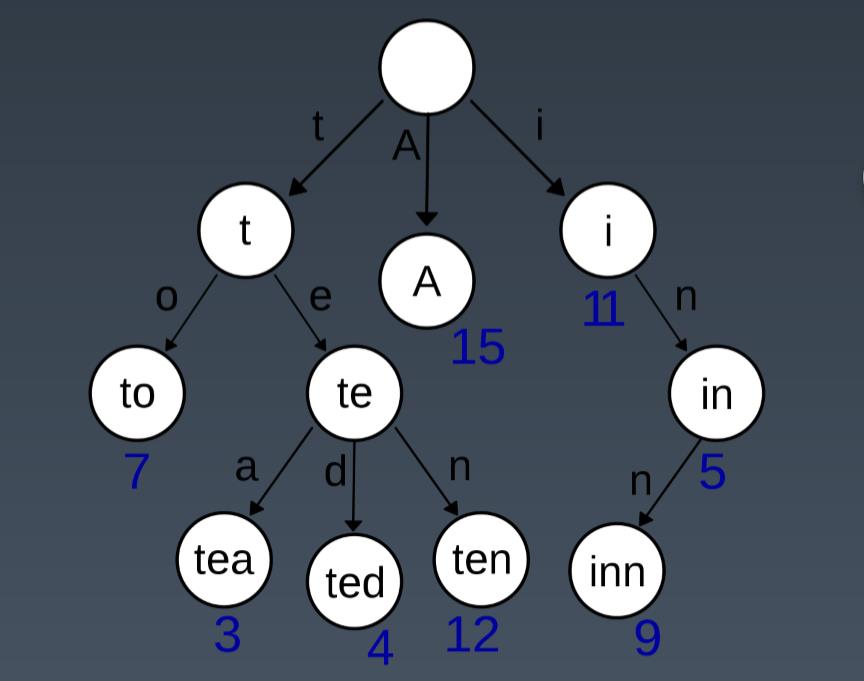
优势
它的优点是:最⼤限度地减少无谓的字符串比较,查询效率⽐哈希表高。
做题总结
- leecode 208
实现一个Trie树,老师在讲义里用python实现了,利用了OrderedDict,使得代码非常简洁。Go语言没有,只能老老实实的用基础数据结构写。
- leecode 720
我一开始想着用Trie树,写了半天,一看简单级别,后来发现如果直接排序后,直接用Map保存并比较结果实现更简单。
分治算法
代码模板
def divide_conquer(problem,param1,param2,...):
    #recursive terminator
    if problem is None:
        print_result
        return
    #prepare data
    data=prepare_data(problem)
    subproblems=split_problem(problem,data)

    #conquer subproblems
    subresult1=self.divide_conquer(subproblems[0],p1,...)
    subresult2=self.divide_conquer(subproblems[1],p1,...)
    subresult3=self.divide_conquer(subproblems[3],p1,...)
    ...

    #process and generate final result
    result=process_result(subresult1,subresult2,subresult3,...)
做题总结
- leecode 240
题解中的方法很巧妙简洁,取一行的最大值,数字小往左移动,数字大往下移动。时间复杂度O(m+n)。
我自己做了一个实现,一开始选中间的位置,将矩阵分成4份,根据中间位置和结果大小关系,去掉1/4数据,代码很长,但是性能更优一点,时间复杂度应该是O(logm*n)
- leecode 53
这道题目可以使用dp方式做,时间复杂度O(n)
我也根据题解实现了分治法,练习了分治的思想,时间复杂度应该是O(nlogn)
贪心算法
定义
贪心算法(英语:greedy algorithm),又称贪婪算法,是一种在每一步选择中都采取在当前状态下最好或最优(即最有利)的选择,从而希望导致结果是最好或最优的算法。
适用场景
简单地说,问题能够分解成子问题来解决,子问题的最优解能递推到最终问题的最优解。这种子问题最优解成为最优子结构。
做题总结
我感觉贪心算法主要是思想,如果题目能够想到用贪心的方法实现,实现的代码会非常简单高效。怎么想到贪心的方法?可能就需要刻意练习吧,感觉到了就简单了。
回溯算法
代码模板
def recursive(level,param1,param2,...)
	#recursive terminator
	if level>MAX_LEVEL:
        print_result
        return

    #process logic in current level
    process_data(level,data,...)

    #drill down
    self.recursive(level+1,p1,...)

    # reverse current level state
    reverse_state(level)
做题总结
- leecode 51
N-queens 老师在线下课的时候讲了两种写法,都是回溯算法,第二种利用了位运算,性能更好,记住横竖撇捺四个方向,然后套用回溯算法的模板,思路还是很清晰的,代码需要多练习两遍。
动态规划
代码模板
// 一维dp
dp=new int[n+1]  # init DP array
for i=1 to n:    # problem size
	dp[i]=f(dp[i-1],dp[i-1],...)
return dp[n]

// 二维dp
dp=new int[n+1][m+1]
for i=1 to n:
	for j=1 to m:
		dp[i][j]=f(dp[i-1][j],dp[i][j-1])
return dp[n][m]/max(dp[n])
做题总结
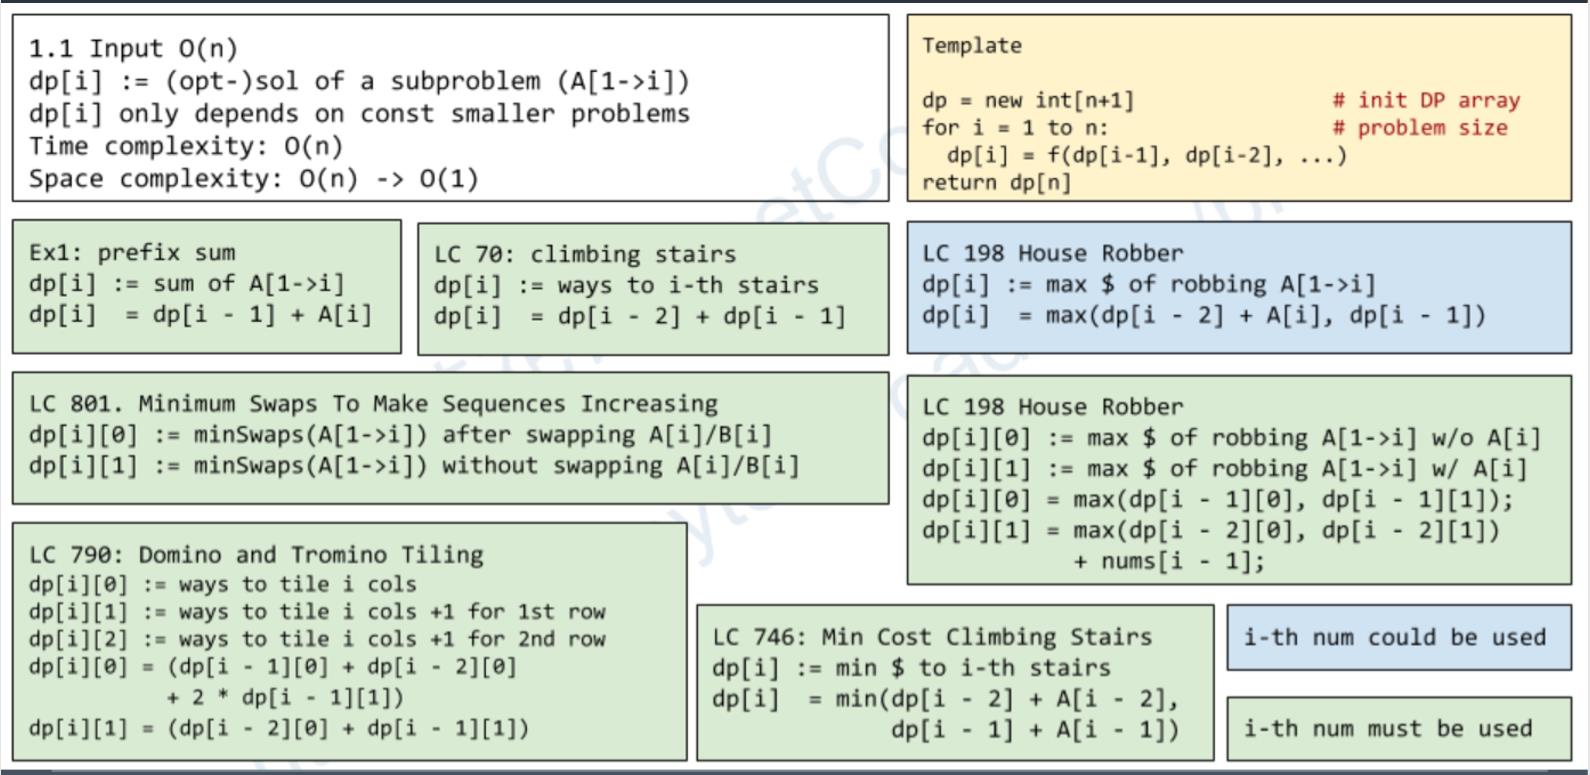
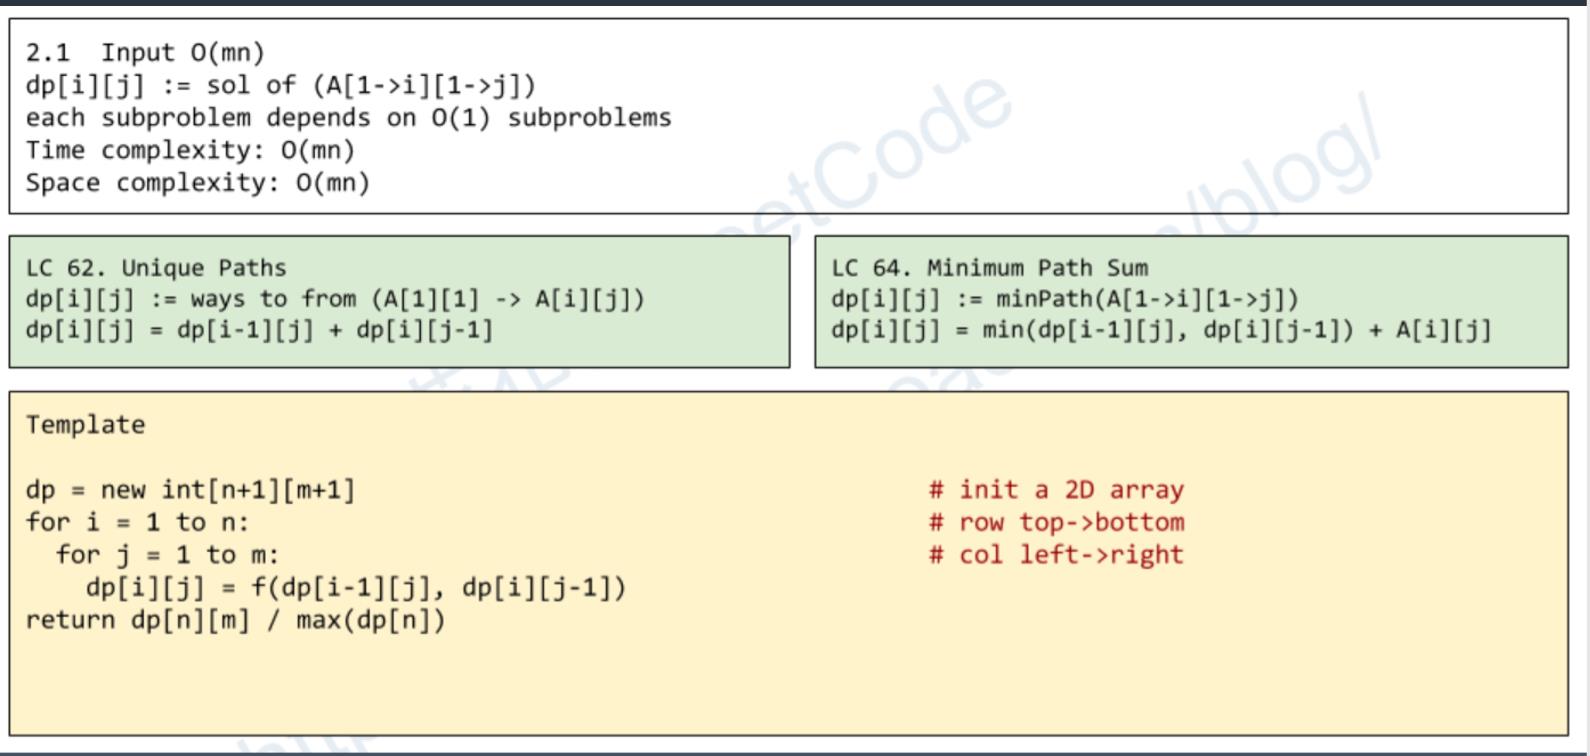
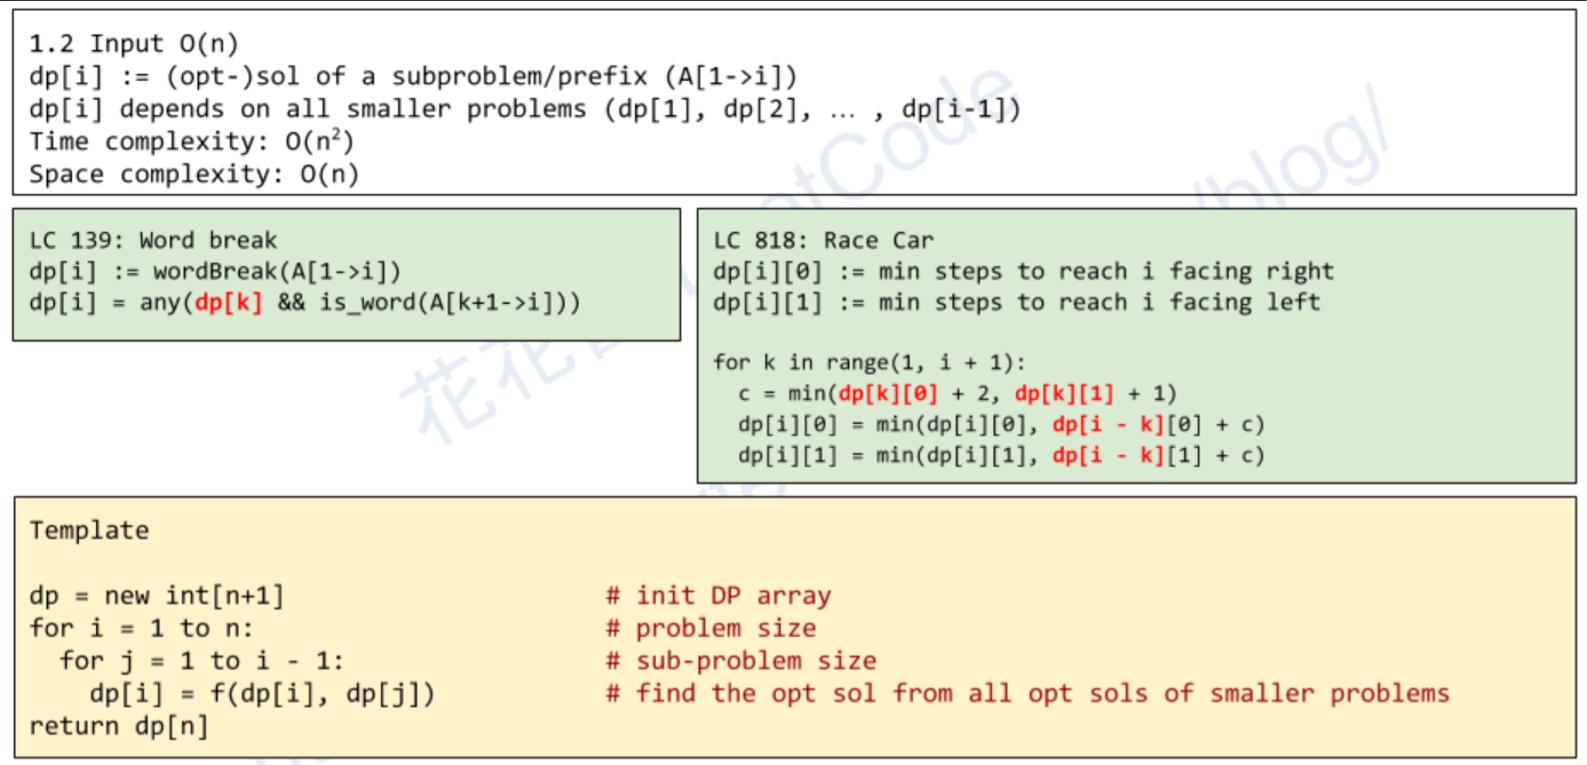
周三的线上课,覃超老师对DP做了非常详细的总结,我将讲义中DP部分截图保存下来,准备跟着它练习。截图如下:
总结
这次作业是算法课最后一次提交作业了,这一个月的训练很艰苦,但是对我的帮助很大,我本身工作压力也不小,要在工作之余,抽时间学习,不容易,坚持学习不松懈就更不容易了。越到后面,我越发现自己的热情在消退,一开始做算法题会仔细的分析,会做很详细的总结,做这些并不觉得辛苦。到了最后几周,多做一道题,多写几行字都变得很艰难,心中总有个声音:你的数量足够了,你写得够多了,可以完成作业了。
但是每次看到微信群中优秀同学之间的讨论、听到覃超老师直播中精彩的课程、每周review比我好得多的代码和学习总结。就觉得应该再努力努力,于是我又多做了几个题目,总结又多写了几行字。
现在回顾自己一个月里自己做的作业和总结,自己也感到骄傲,可能我的代码写得并不优秀,数量也不是那么多,我的总结也没什么技术含量,但是我尝试了,我努力了,我坚持了下来。同时我也看到了自己的不足,现在回头重新做之前的困难题,并不如想象的那么顺手,五毒神掌,我只练了两掌,刻意练习做起来真的很难。所以我还要继续努力。
一个月的时间很短暂,一眨眼就结束了,从这门课程中我不止学到了算法的知识,更学到了很多很有价值的方法和思想,很多是我需要继续努力精进的,课程的结束不是终点,而是一个新的起点,未来还需坚持下去,做更好的自己。
Activity